Before HiPPO: 구조화된 memory
현대 RNN 연구에서 GRU
이러한 문제에 구조를 부여한 사례로는 Fourier basis로 과거 정보를 표현한 FRU
| 방법 | 설명 |
|---|---|
| Fourier Recurrent Unit (FRU) |
Fourier 기저를 이용해 과거 은닉 상태를 요약합니다. |
| Legendre Memory Unit (LMU) |
Legendre 다항식으로 시간 구간의 입력 이력을 표현합니다. |
| Correlation Recurrent Unit (CRU) |
추세와 계절성 등 시계열의 상관 구조를 반영합니다. |
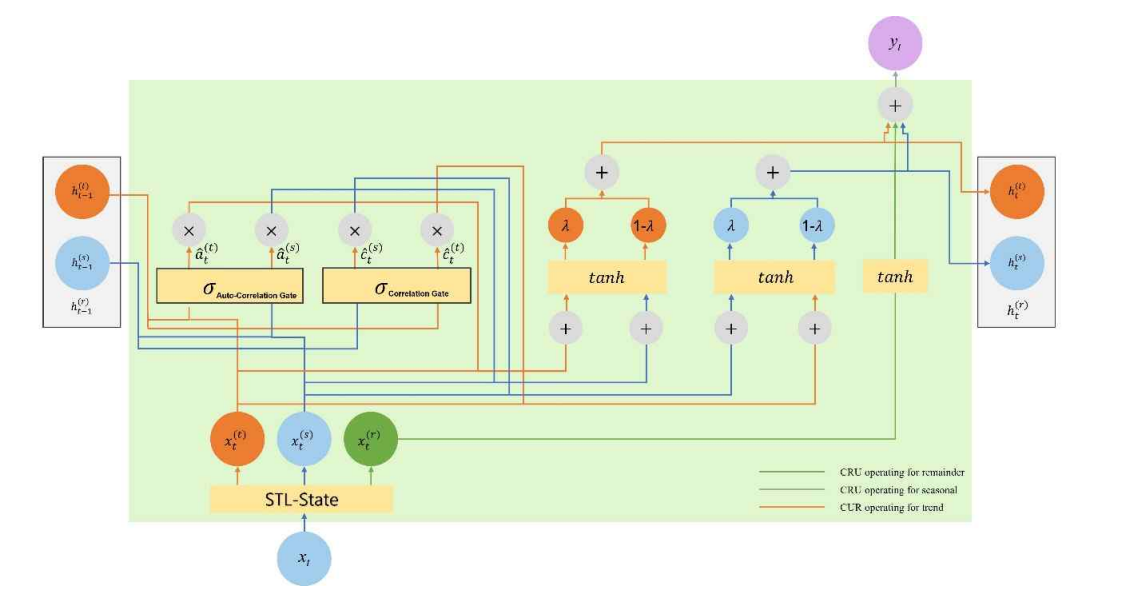
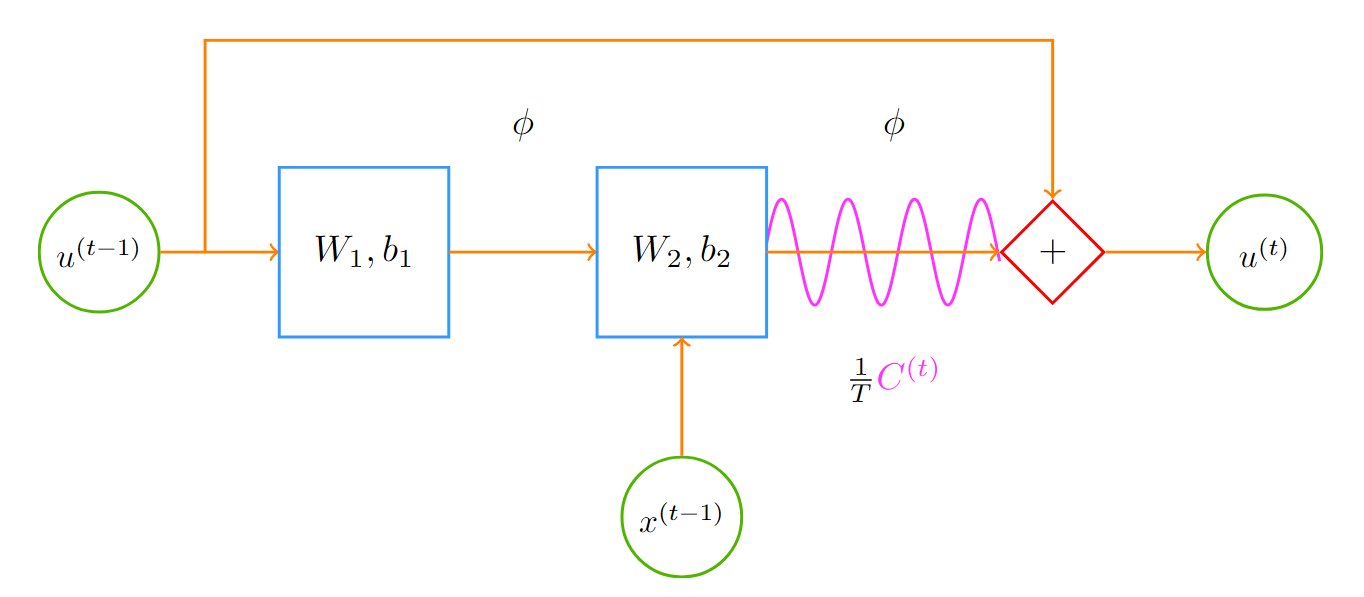
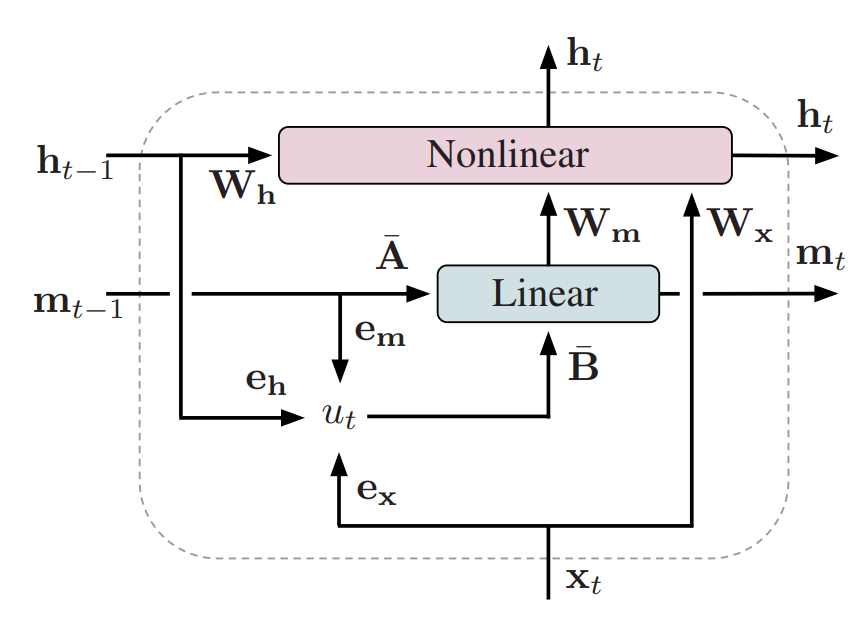
HiPPO: Recurrent Memory with Optimal Polynomial Projection
앞서 살펴본 방법들은 모두 과거 입력을 그대로 저장하는 대신, 특정한 inductive bias를 가진 구조로 분해해 요약합니다. HiPPO는 이 아이디어를 Hilbert space에서의 projection 문제로 발전시킵니다. 구체적으로는 orthogonal polynomial basis를 사용해, 새로운 signal이 들어올 때마다 지금까지의 이력을 optimal finite-dimensional projection coefficient로 압축해 저장합니다. 이를 online approximation이라고 합니다. 이때 시간을 정규화하면 구간 길이가 달라져도 동일한 polynomial-family 좌표계 안에서 memory를 일관되게 표현하고 갱신할 수 있습니다.
아래 자료는 이러한 online approximation 문제를 Legendre basis 위에서 간단히 시각화한 것입니다.
Online Approximation
Signal memory
coefficient vector c(t)
Legendre basis, $u\in[-1,1]$
HiPPO의 핵심 아이디어는 “지금까지 관측한 함수 이력 $f_{\leq t}$를 orthogonal polynomial space에 projection한다”는 것입니다. 이를 수식으로 표현하면 다음과 같습니다.
여기서 $\mu_t$는 과거 각 시점의 중요도를 정하는 measure이고, $\phi_i^{(t)}$는 해당 measure에 대해 orthogonal한 basis function입니다. HiPPO는 전체 이력을 저장하는 대신 coefficient vector $c(t)$만 유지하며, 선택한 measure와 basis에 맞추어 이 vector를 갱신하는 rule을 유도합니다.
\[\frac{d}{dt}c(t)=-A(t)c(t)+B(t)f(t).\]대표적으로 HiPPO에서 사용하는 Legendre-scaled(LegS)와 translated Laguerre(LagT)의 measure는 다음과 같습니다.
\[\mu_{\mathrm{LegS}}^{(t)}(x) =\frac{1}{t}\mathbf{1}_{[0,t]}(x), \qquad \mu_{\mathrm{LagT}}^{(t)}(x) =e^{-(t-x)}\mathbf{1}_{(-\infty,t]}(x).\]LegS는 시점 $t$까지의 전체 구간을 균일하게 보면서, 구간 길이가 늘어나더라도 같은 Legendre basis를 사용할 수 있도록 시간을 scale합니다. 반면 LagT는 현재에서 멀어질수록 가중치를 지수적으로 줄입니다. 따라서 measure를 선택한다는 것은 모델이 기억할 시간 범위와 망각 방식을 함께 정한다는 의미입니다.
이렇게 정한 measure와 basis로부터 coefficient의 continuous-time update를 유도할 수 있습니다.
로 쓸 수 있으며, 여기서 continuous-time operator $A^{\mathrm{LegS}},B^{\mathrm{LegS}}$는 다음과 같습니다.
\[A_{nk}^{\mathrm{LegS}} =\begin{cases} (2n+1)^{1/2}(2k+1)^{1/2}, & n>k,\\ n+1, & n=k,\\ 0, & n<k. \end{cases}\] \[B_n^{\mathrm{LegS}}=(2n+1)^{1/2}.\]LagT는 $\dot c(t)=-A^{\mathrm{LagT}}c(t)+B^{\mathrm{LagT}}f(t)$인 LTI system이며, operator는 다음과 같습니다.
\[A_{nk}^{\mathrm{LagT}} =\begin{cases} 1, & n\geq k,\\ 0, & n\lt k. \end{cases}\] \[B_n^{\mathrm{LagT}}=1.\]따라서 LegS의 $A^{\mathrm{LegS}}$는 lower-triangular matrix입니다. 앞의 식을 네 개의 basis에 대해 전개하면 다음과 같습니다.
\[A^{\mathrm{LegS}}= \begin{bmatrix} 1 & & & & \cdots\\ \sqrt{3} & 2 & & & \cdots\\ \sqrt{5} & \sqrt{15} & 3 & & \cdots\\ \sqrt{7} & \sqrt{21} & \sqrt{35} & 4 & \cdots\\ \vdots & \vdots & \vdots & \vdots & \ddots \end{bmatrix}.\]대각 원소는 $n+1$이며, lower-triangular 부분은 두 basis index에 따라 정해지는 square-root 계수로 구성됩니다. 여기에 Euler method를 적용하면 time index $m\geq1$에서의 discrete update는 $c_{m+1}=(I-A/m)c_m+(B/m)f_m$이 됩니다. 이때 위에서 정의한 $A,B$ 자체와 실제 discrete transition인 $\overline A_m=I-A/m$, $\overline B_m=B/m$은 서로 구분해야 합니다.
이에 대응해 LagT는 훨씬 단순한 unit lower-triangular matrix로 쓸 수 있습니다.
\[A^{\mathrm{LagT}}= \begin{bmatrix} 1 & & & \cdots\\ 1 & 1 & & \cdots\\ 1 & 1 & 1 & \cdots\\ \vdots & \vdots & \vdots & \ddots \end{bmatrix}, \qquad A_{nk}^{\mathrm{LagT}}= \begin{cases} 1, & n\geq k,\\ 0, & n\lt k. \end{cases}\]두 matrix는 모두 임의로 정한 dense matrix가 아니라, 선택한 basis와 measure에서 유도된 규칙적인 operator입니다. LegS는 지금까지의 전체 이력을 같은 상대적 시간 축에서 근사하기 때문에 basis 차수에 따라 square-root coefficient가 달라지는 반면, LagT는 오래된 정보를 지수적으로 덜 반영하면서 unit lower-triangular 구조를 갖습니다.
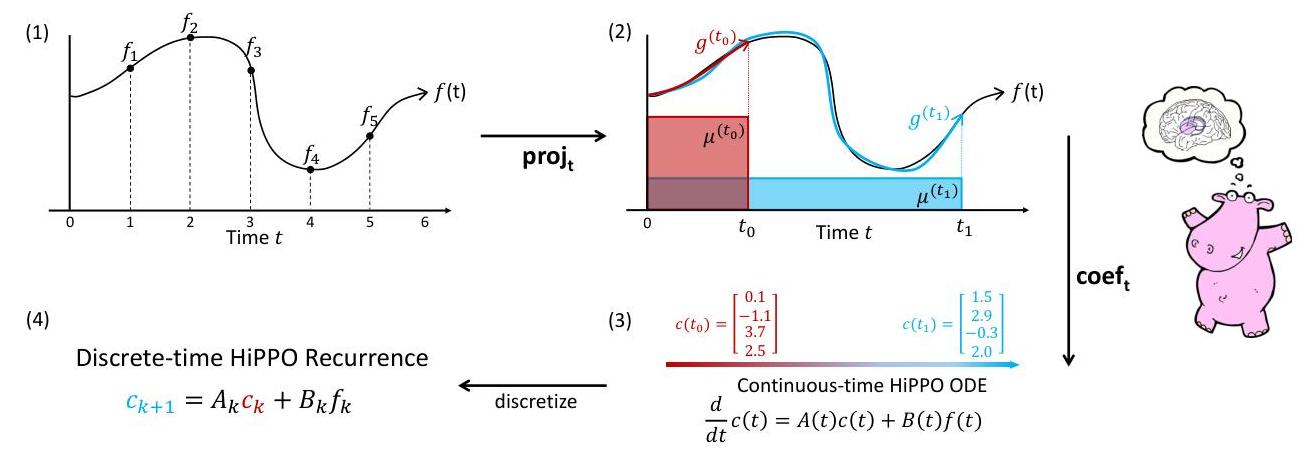
제가 보기에 HiPPO의 가장 큰 전환점은 measure별 optimal online projection을 하나의 framework로 정리하고, 과거 전체를 저장하지 않은 채 “각 basis가 과거 signal을 얼마나 설명하는가”를 coefficient vector $c(t)$로 갱신하는 dynamics를 유도했다는 점입니다. 이처럼 memory를 정규화된 polynomial 좌표로 표현하면 비교·결합·선형 변환을 일관된 space 안에서 정의할 수 있습니다. 또한 압축된 memory가 새 입력을 만났을 때 어떻게 바뀌는지는 $A(t)$와 $B(t)$가 결정하므로, basis와 measure로 정한 기억 방식이 상태 전이 행렬의 구조로 이어집니다.
After HiPPO
HiPPO 이후에는 function space에서 measure로 정의한 memory를 실제 recurrent model의 유한한 $A,B$ update로 어떻게 구현할 것인가라는 과제가 남았습니다. HiPPO에서는 measure와 basis를 정하면 그에 대응하는 state transition $A$가 유도되는데, LSSL은 이 관계를 역방향으로도 볼 수 있음을 보여줍니다.
새 observation이 들어올 때마다 과거 전체를 다시 보지 않고 coefficient를 갱신하려면, 원하는 projection의 update가 유한한 state 안에서 닫혀야 합니다. 동시에 긴 sequence에서도 이 update를 효율적으로 계산할 수 있도록 $A$의 구조를 활용해야 합니다. 적절한 Low recurrence width(LRW)를 만족하는 $A$가 주어지면 이를 유도하는 measure가 존재하므로, $A$ 자체를 학습하더라도 여전히 어떤 function-space memory를 구현한 것으로 해석할 수 있습니다.
LRW를 만족하는 행렬 $A\in\mathbb{R}^{N\times N}$의 $i$번째 행을 다항식 $a_i(X)=\sum_{k=0}^{N-1}A[i,k]X^k$로 나타낼 때, recurrence width $r$은 다음 관계로 정의됩니다.
\[a_i(X)=\sum_{j=1}^{r}g_{i,j}(X)a_{i-j}(X), \qquad \deg g_{i,j}\leq j, \qquad i\geq r.\]또한 recurrence를 시작하는 앞의 $r$개 행은 $\deg a_i\leq i\;(0\leq i<r)$를 만족합니다.
이러한 성질을 이용하면 LSSL에서는 Legendre measure에서 유도한 $A$로 초기화한 뒤, LRW 구조를 유지하는 범위에서 $A$를 학습할 수 있습니다. 학습된 $A$가 처음의 Legendre measure와 같을 필요는 없지만, 여전히 그에 대응하는 measure가 존재하므로 function-space projection이라는 해석은 유지됩니다. 이후의 현대 SSM 연구는 이 지점을 출발점으로 삼아, 상태 전이 $A$에 얼마나 많은 표현력을 허용할지와 계산 효율을 어떻게 유지할지를 함께 탐구합니다.
그 기본 형태는 다음의 continuous-time state-space system과 이를 이산화한 recurrence로 나타낼 수 있습니다.
\[\begin{aligned} h'(t)&=Ah(t)+Bx(t), & y(t)&=Ch(t),\\ h_t&=\overline{A}h_{t-1}+\overline{B}x_t, & y_t&=Ch_t. \end{aligned}\]$A,B$는 연속 시간 동역학을 정의하고, $\overline A,\overline B$는 여기에 step size와 이산화 방법을 적용해 얻은 전이입니다. 따라서 같은 연속 시간 모델이라도 zero-order hold나 bilinear transform 같은 방법을 어떻게 적용하느냐에 따라 실제 recurrence는 달라집니다. 앞의 HiPPO 절에서는 stable decay를 드러내기 위해 $\dot c=-Ac+Bf$로 썼지만, 여기서는 일반적인 SSM 표기인 $\dot h=Ah+Bx$를 사용하므로 $A$의 부호 convention이 서로 다릅니다.
아래 표는 이 관점에서 본 현대 딥러닝 SSM의 발전을 요약합니다. 더 자세한 내용은 발표자료에 정리되어 있습니다.
| 연구 | 핵심 아이디어 |
|---|---|
| LSSL |
HiPPO에서 유도한 structured $A$를 SSM layer에 넣고, quasiseparable 가족의 $A$와 timescale까지 그냥 학습하자. |
| S4 |
HiPPO matrix의 normal-plus-low-rank 구조를 DPLR로 바꿔, 긴 convolution kernel을 효율적으로 계산하자. |
| S4D |
$A$는 diagonal로 단순화하되, HiPPO/S4에서 유도한 초기화는 살리자. |
| Mamba |
기본 $A$는 공유하되, 입력별 $\Delta_t,B_t,C_t$로 이산화된 transition과 read/write를 selective하게 만들자. |
| Mamba2 |
head별 transition을 scalar $\alpha_t I$로 단순화해 SSM–attention duality와 효율적인 병렬 알고리즘을 얻자. |
Mamba에서 연속 시간의 기본 파라미터 $A$는 입력과 무관하게 학습됩니다. 다만 입력에 따라 달라지는 $\Delta_t$, $B_t$, $C_t$를 통해 이산화된 상태 전이가 입력 의존적으로 바뀐다는 점은 구분해야 합니다.
이후 연구들은 이처럼 state transition에 어느 정도의 자유도를 허용할지, 그리고 그 계산을 어떻게 효율적으로 유지할지를 함께 탐구했습니다.
LONGHORN: STATE SPACE MODELS ARE AMORTIZED ONLINE LEARNERS
AN ONLINE LEARNING PERSPECTIVE FOR SEQUENCE MIXING
HiPPO에서 Mamba2까지의 흐름은 구조화된 state transition을 얼마나 효율적이고 표현력 있게 만들 수 있는지에 초점을 두었습니다. 다만 모델이 발전할수록 학습된 selective transition과 read/write의 중요성이 커졌기 때문에, 이 흐름 전체를 HiPPO의 online approximation 문제를 그대로 풀어 온 과정이라고 보기는 어렵습니다.
Longhorn
$D_\Phi$는 상태를 바꾸는 비용이고 $\ell_t$는 현재 관측에 대한 손실이며, $\beta_t$는 새 정보를 반영하는 정도를 조절합니다. 결국 이 목적함수는 이전 memory를 유지하려는 힘과 현재 observation에 적응하려는 힘 사이의 균형을 찾습니다.
Online linear regression
Online-learning-based linear regression
각 observation $(x_t,y_t)$가 도착할 때마다 이전 직선에서 너무 멀어지지 않으면서 현재 점의 prediction error를 줄이는 $\theta_t=[b_t,w_t]$를 선택합니다. Longhorn update의 핵심 아이디어를 2차원으로 단순화한 예시입니다.
post-update residual 0.00
Longhorn의 목적함수는 다음과 같습니다.
\[S_t=\underset{S\in\mathbb{R}^{d_v\times d_k}}{\operatorname{argmin}} \left[ \|S-S_{t-1}\|_F^2 +\|Sk_t-v_t\|_{\operatorname{Diag}(\boldsymbol{\beta}_t)}^2 \right],\]해석을 단순하게 하기 위해 모든 value channel이 같은 scalar $\beta_t\geq0$를 사용한다고 가정하면, 목적함수는 다음과 같이 정리됩니다.
\[S_t=\underset{S}{\operatorname{argmin}} \left[\frac12\|S-S_{t-1}\|_F^2 +\frac{\beta_t}{2}\|Sk_t-v_t\|_2^2\right],\]이 목적함수를 $\mathcal{L}_t$로 두겠습니다.
\[\mathcal{L}_t(S) =\frac12\|S-S_{t-1}\|_F^2 +\frac{\beta_t}{2}\|Sk_t-v_t\|_2^2.\] \[d\mathcal{L}_t=\left\langle S-S_{t-1},dS\right\rangle_F +\beta_t\left\langle Sk_t-v_t,dS\,k_t\right\rangle_2.\]두 번째 항을 Frobenius inner product로 다시 쓰면
\[d\mathcal{L}_t =\left\langle S-S_{t-1}+\beta_t(Sk_t-v_t)k_t^\top, dS \right\rangle_F.\]따라서 gradient는 다음과 같습니다.
\[\nabla_S\mathcal{L}_t(S) =S-S_{t-1}+\beta_t(Sk_t-v_t)k_t^\top.\]최적점 $S_t$에서는 gradient가 $0$이므로
\[0=S_t-S_{t-1}+\beta_t(S_tk_t-v_t)k_t^\top.\]$S_t$에 관한 항을 한쪽으로 모으면
\[S_t(I+\beta_tk_tk_t^\top) =S_{t-1}+\beta_tv_tk_t^\top.\]여기서 Sherman-Morrison identity를 적용합니다.
\[(I+\beta_tk_tk_t^\top)^{-1} =I-\frac{\beta_t}{1+\beta_t\|k_t\|_2^2}k_tk_t^\top\]이를 오른쪽에서 곱해 정리하면 다음의 closed-form update를 얻습니다.
\[S_t=S_{t-1} +\frac{\beta_t}{1+\beta_t\|k_t\|_2^2} (v_t-S_{t-1}k_t)k_t^\top.\]이 update는 현재 memory의 prediction error를 이용해 state를 수정하고, 분모를 통해 유효한 update의 크기를 조절합니다. Value channel별로 $\boldsymbol{\beta}_t\in(0,1)^{d_v}$를 사용하면 같은 해를 다음처럼 차원에 맞추어 묶어 쓸 수 있습니다.
\(\boldsymbol{\varepsilon}_t =\frac{\boldsymbol{\beta}_t} {1+\boldsymbol{\beta}_t\,k_t^\top k_t},\) 여기서 위 분수는 value channel별 element-wise 연산입니다.
\[S_t =S_{t-1} +\left[\boldsymbol{\varepsilon}_t\odot \left(v_t-S_{t-1}k_t\right)\right]k_t^\top.\]이 식의 $i$번째 행은 $S_{t,i:}=S_{t-1,i:}(I-\varepsilon_{t,i}k_tk_t^\top)+\varepsilon_{t,i}v_{t,i}k_t^\top$입니다. 따라서 위의 channel별 식을 matrix 전체에 그대로 옮겨 하나의 $\varepsilon_{t,i}$를 모든 행에 적용하면 차원이 맞지 않습니다.
여기까지 유도한 식은 squared-loss proximal objective의 정확한 closed-form solution입니다. 그러나 실제 Longhorn layer에서는 dense rank-one transition을 parallel scan에 적합한 element-wise decay로 근사하여 다음 recurrence를 사용합니다.
\[S_t= \left(\mathbf{1}_{d_v\times d_k} -\boldsymbol{\varepsilon}_t(k_t^{\odot2})^\top\right)\odot S_{t-1} +(\boldsymbol{\varepsilon}_t\odot v_t)k_t^\top.\]따라서 Longhorn을 이해하려면 objective가 주는 정확한 update와 실제 모델이 효율을 위해 사용하는 대각 근사를 구분해야 합니다.
After LONGHORN
Learning Objective in Online Learning
Longhorn에서 제가 중요하게 본 변화는 sequence mixer를 learning objective와 그에 대응하는 update rule의 쌍으로 다시 설명했다는 점입니다. 이는 Longhorn 이후의 모든 모델이 새롭게 따르기 시작한 순서라기보다, 기존 recurrence까지 inner-state objective의 관점에서 소급해 해석할 수 있게 해 주는 framework에 가깝습니다. 발표에서 사용한 표기를 따르면, 현재 state에서 최대화하려는 score $L_t$에 대해 다음 objective를 둘 수 있습니다.
\[S_t=\underset{S}{\operatorname{argmin}} \left[\frac{1}{2}\|S-S_{t-1}\|_F^2-\eta_tL_t(S)\right].\]최적점의 stationarity condition은 다음과 같습니다.
\[S_t-S_{t-1}-\eta_t\nabla L_t(S_t)=0, \qquad S_t=S_{t-1}+\eta_t\nabla L_t(S_t).\]이 식은 gradient를 새로운 state $S_t$에서 평가하므로 implicit update에 해당합니다. $L_t=-\ell_t$로 두면 loss minimization 표기와도 같은 방향으로 해석할 수 있습니다.
이 관점에서 보면 Linear Attention
가 됩니다. 따라서 이전 state를 유지하는 항과 이 score를 최대화하는 항을 함께 두면 $v_tk_t^\top$ 형태의 write update가 자연스럽게 나타납니다.
Longhorn은 여기서 한 단계 더 나아가, alignment score 자체를 최대화하는 대신 prediction error $|Sk_t-v_t|_2^2$를 최소화합니다. 이 항은
\[\|Sk_t-v_t\|_2^2 =\|Sk_t\|_2^2-2\langle Sk_t,v_t\rangle+\|v_t\|_2^2\]로 전개됩니다. LA의 inner product 항을 포함하면서도 $Sk_t$의 크기까지 함께 제어하기 때문에, 단순히 $v_t$와 같은 방향을 향하게 하는 데 그치지 않고 현재 key에 대해 $v_t$를 실제로 예측하도록 state를 보정합니다. 아래 표에서 LA, RetNet, GLA는 기본 write에 서로 다른 방식의 memory retention을 결합한 형태이며, Longhorn은 여기에 residual을 줄이는 write objective를 도입한 경우로 볼 수 있습니다.
Online learning objective와 update를 이 글의 notation으로 옮기면 다음과 같습니다.
| Method | Online Learning Objective | Online Update |
|---|---|---|
| LA |
$ \bigl\|S-S_{t-1}\bigr\|_F^2 -2\langle Sk_t,v_t\rangle$ | $S_t=S_{t-1}+v_tk_t^\top$ |
| Mamba2 |
$ \bigl\|S-\alpha_tS_{t-1}\bigr\|_F^2 -2\langle Sk_t,v_t\rangle$ | $S_t=\alpha_tS_{t-1}+v_tk_t^\top$ |
| RetNet |
$ \gamma\bigl\|S-S_{t-1}\bigr\|_F^2 +(1-\gamma)\bigl\|S\bigr\|_F^2 -2\langle Sk_t,v_t\rangle$ | $S_t=\gamma S_{t-1}+v_tk_t^\top$ |
| GLA |
$ \bigl\|S-S_{t-1}\operatorname{Diag}(\boldsymbol{\alpha}_t)\bigr\|_F^2 -2\langle Sk_t,v_t\rangle$ | $S_t=S_{t-1}\operatorname{Diag}(\boldsymbol{\alpha}_t)+v_tk_t^\top$ |
| Griffin |
$ \bigl\|\sqrt{\boldsymbol{\alpha}_t}\odot(s-s_{t-1})\bigr\|_2^2 +\bigl\|\sqrt{1-\boldsymbol{\alpha}_t}\odot s\bigr\|_2^2 -2\left\langle\sqrt{1-\boldsymbol{\alpha}_t}\odot(s\odot i_t),x_t\right\rangle$ | $s_t=\boldsymbol{\alpha}_t\odot s_{t-1}+\sqrt{1-\boldsymbol{\alpha}_t}\odot i_t\odot x_t$ |
| Longhorn |
$ \bigl\|S-S_{t-1}\bigr\|_F^2 +\bigl\|Sk_t-v_t\bigr\|_{\operatorname{Diag}(\boldsymbol{\beta}_t)}^2$ | actual layer: diagonal approximation $ S_t=\left(\mathbf{1}_{d_v\times d_k}-\boldsymbol{\varepsilon}_t(k_t^{\odot2})^\top\right)\odot S_{t-1} +(\boldsymbol{\varepsilon}_t\odot v_t)k_t^\top, \quad \boldsymbol{\varepsilon}_t=\frac{\boldsymbol{\beta}_t}{1+\boldsymbol{\beta}_t k_t^\top k_t}$ |
세부적인 gate와 feature의 parameterization은 모델마다 다르지만, 공통된 기준은 분명합니다. 이전 state를 어떤 형태로 보존하거나 감쇠할지와 현재 observation을 어떤 형태로 memory에 기록할지를 함께 정한다는 점입니다.
다만 objective의 정확한 해를 구하는 implicit update와 이전 state에서 gradient를 계산해 한 단계 이동하는 explicit gradient step은 구분해야 합니다. Explicit update는
\[S_t=S_{t-1}-\eta_t\nabla\ell_t(S_{t-1})\]처럼 이전 state의 gradient를 사용하므로, 같은 loss와 learning rate를 사용하더라도 일반적으로 implicit update와는 다른 recurrence가 됩니다. 결국 objective만으로 모델이 완전히 정해지는 것은 아니며, 이를 정확히 풀 것인지 한 번의 gradient step으로 근사할 것인지에 따라 서로 다른 sequence mixer가 만들어집니다.
Self-Attention VS Online-Learning: KV cache와 fixed-size state
Causal self-attention은 autoregressive inference 과정에서 과거 token의 key·value tensor를 KV cache에 보관하므로, cache 크기와 token별 조회량이 sequence 길이에 따라 늘어납니다. 반면 앞에서 다룬 recurrent sequence mixer는 과거를 고정 크기의 state tensor에 압축하고 새로운 observation이 들어올 때마다 이 state를 update합니다.
이 비교에서 TTT
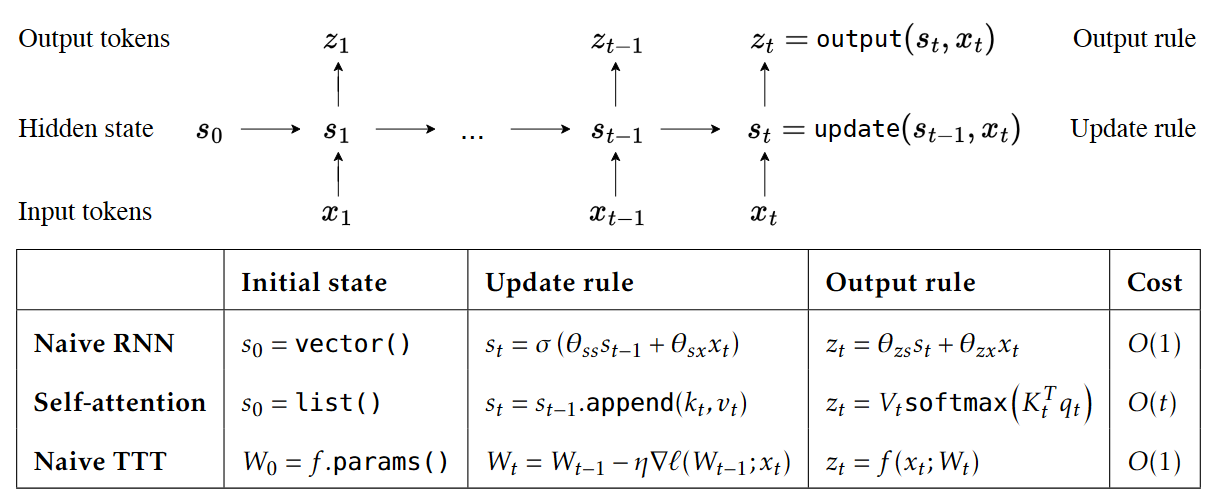
이제 fixed-size matrix state로 돌아와 현재 memory의 오차를 직접 보정하는 delta rule을 살펴보겠습니다.
GATED DELTA NETWORKS: IMPROVING MAMBA2 WITH DELTA RULE
Longhorn의 objective–update framework를 통해 DeltaNet
이 update는 앞 절의 squared loss에 대해 이전 state에서 explicit gradient step을 수행하면 얻을 수 있습니다. Key-value outer product를 단순히 계속 더하는 방식과 달리 이미 저장된 내용과 새 observation의 차이를 반영하므로, 같은 key에 잘못 연결된 정보가 있을 때 새 value 자체가 아니라 prediction error를 이용해 해당 연결을 직접 보정할 수 있습니다.
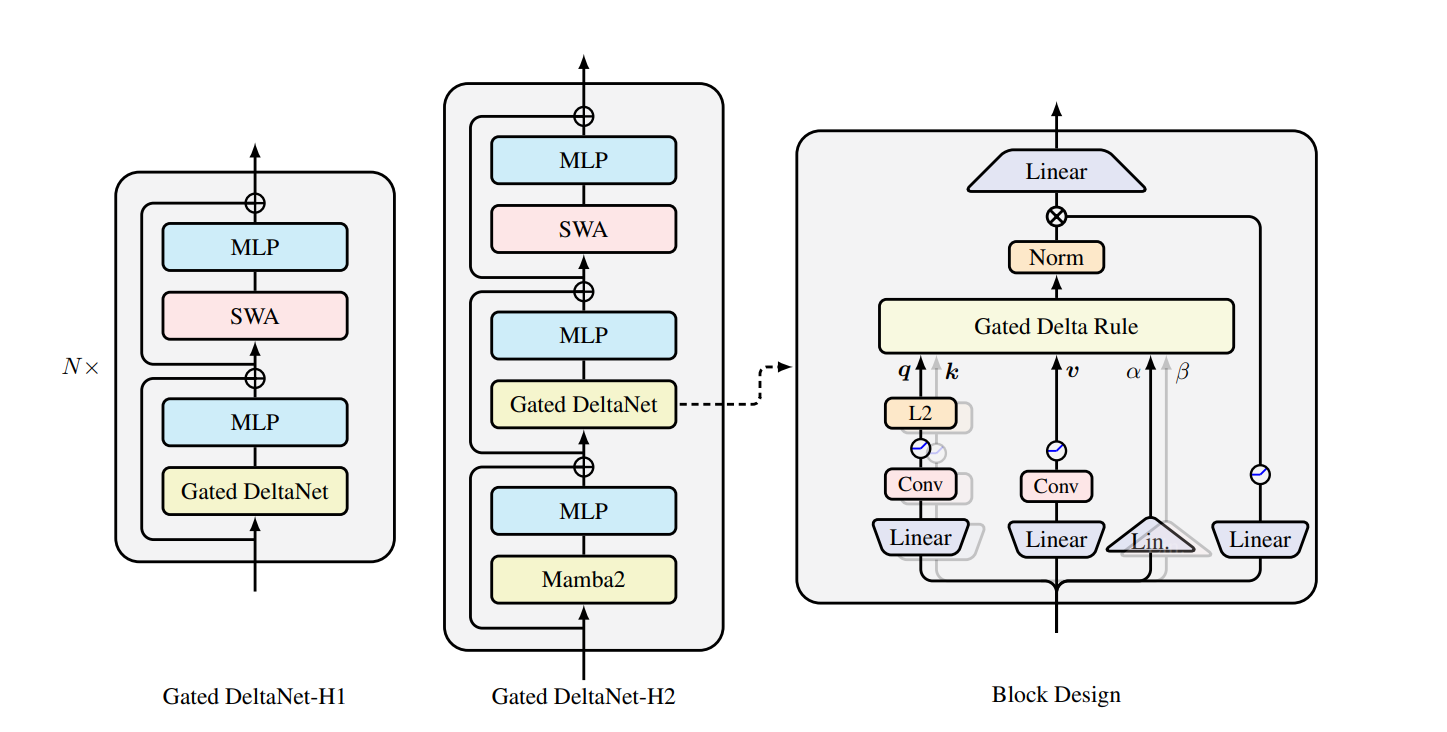
Gated DeltaNet은 여기에 이전 memory의 retention을 조절하는 gate $\alpha_t$를 결합합니다.
$\alpha_t$는 이전 state를 얼마나 남길지를 조절하고, $\beta_t$는 현재 key에 대한 correction을 얼마나 반영할지를 결정합니다. 같은 식을 $\alpha_tS_{t-1}+\beta_t(v_t-\alpha_tS_{t-1}k_t)k_t^\top$로 쓰면, 이전 memory를 먼저 감쇠한 뒤 그 memory가 현재 key에 대해 낸 prediction error를 보정한다는 해석이 더 분명하게 드러납니다.
이러한 관점에서 Gated DeltaNet은 DeltaNet의 residual write와 Mamba2 계열의 selective retention을 결합한 형태로 볼 수 있습니다. 두 모델의 parameterization이 완전히 같다는 의미는 아니지만, decay gate와 correction gate를 함께 사용하는 이유를 직관적으로 설명해 줍니다.
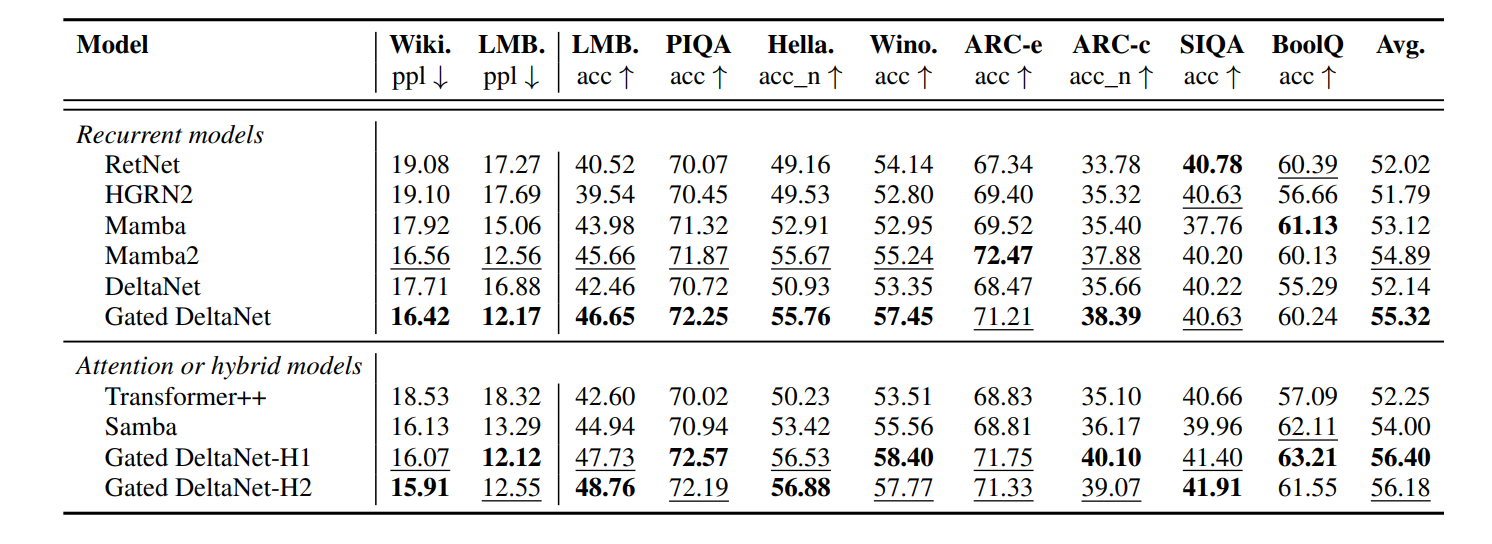
논문에서는 Gated DeltaNet을 sequence mixing 계층으로 평가하는 한편, sliding-window attention 등과 결합한 하이브리드 구성도 실험합니다. 이 결과는 Gated DeltaNet이 attention을 대체하거나 보완할 수 있음을 보여 주지만, softmax attention과 수학적으로 동일한 연산이라는 의미는 아닙니다.
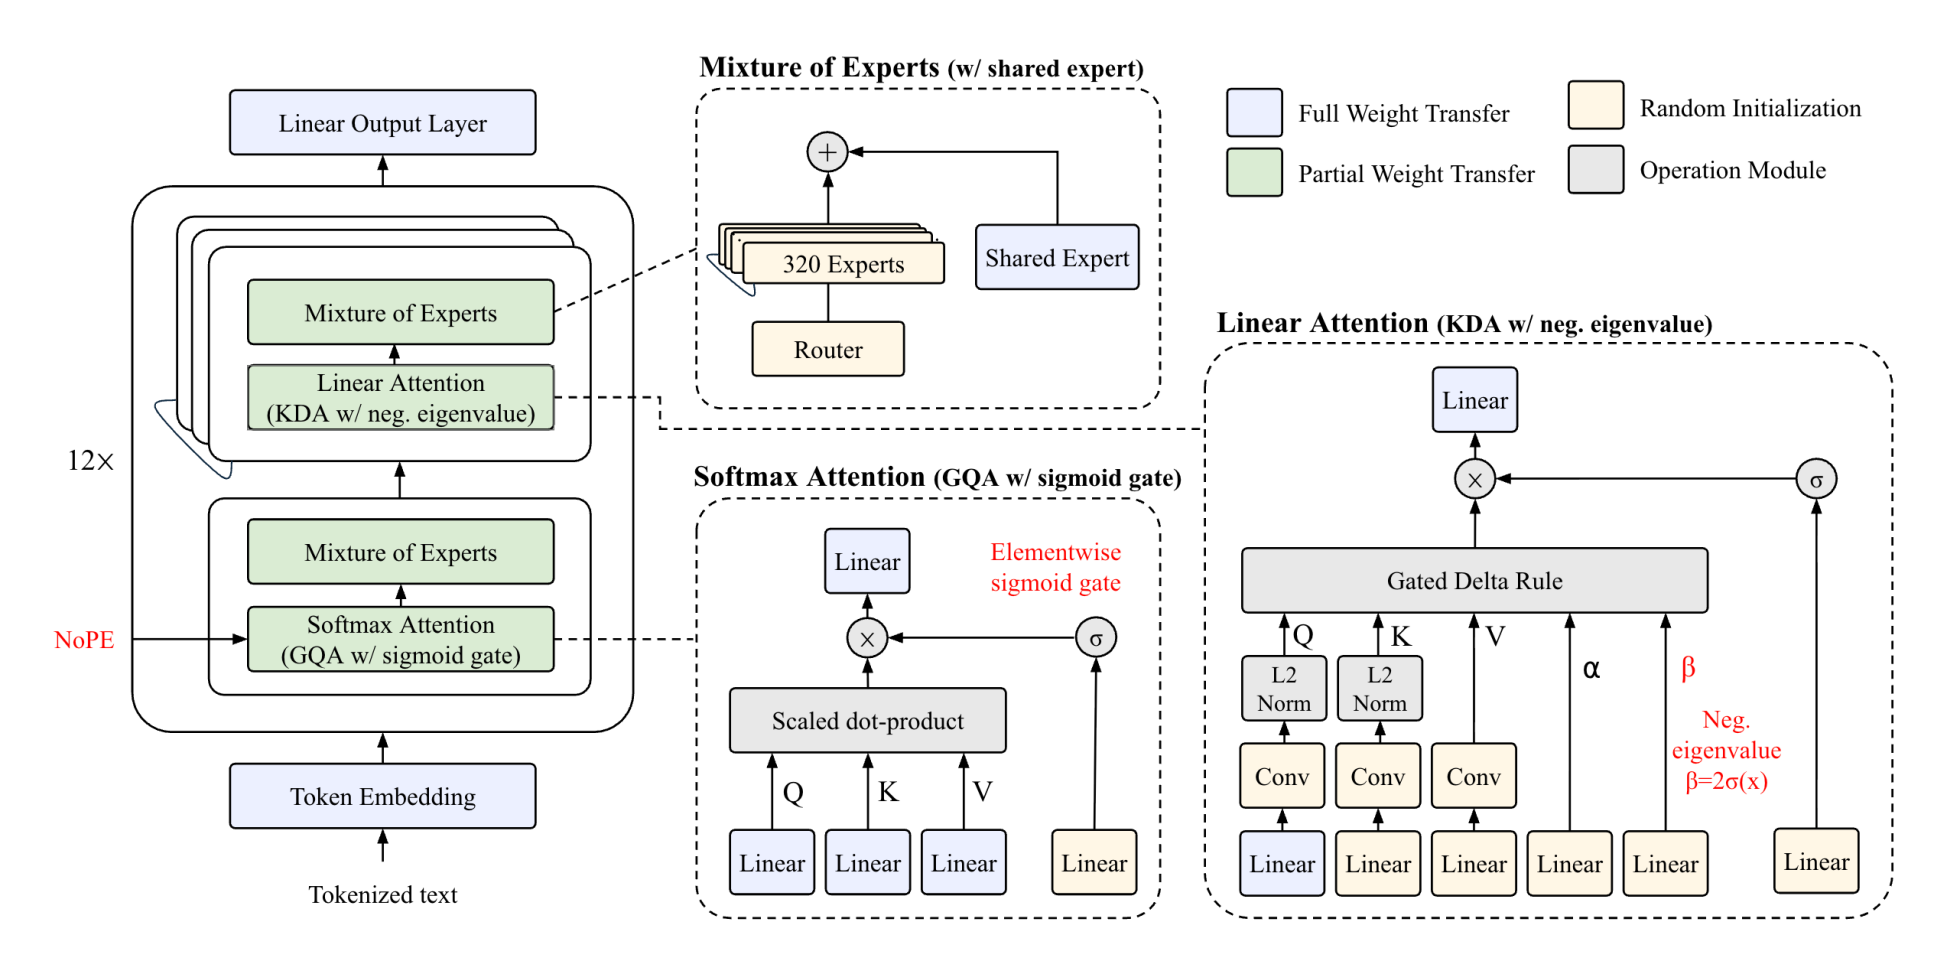
Kimi Delta Attention
Kimi Linear
이 글의 state-matrix notation에서는 update를 다음과 같이 쓸 수 있습니다.
\[S_t=S_{t-1}D_t(I-\beta_tk_tk_t^\top)+\beta_tv_tk_t^\top, \qquad o_t=S_tq_t.\]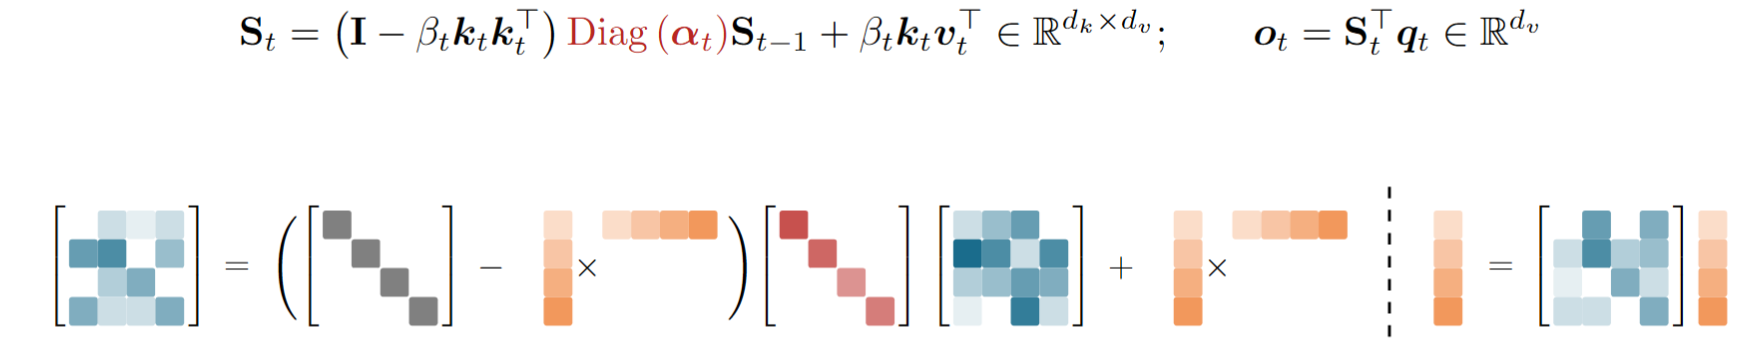
오른쪽에서 상태에 작용하는 전이 행렬을 전개하면
\[A_t=D_t-\beta_t(D_tk_t)k_t^\top\]가 되므로, 이를 diagonal matrix와 rank-one correction의 결합으로 볼 수 있습니다. 다만 행렬 곱의 순서가 중요하기 때문에 $D_t$와 $k_tk_t^\top$를 임의로 교환할 수는 없습니다.
S4의 DPLR(diagonal plus low-rank) 구조와 닮은 형태가 여기서는 채널별 decay와 delta update를 표현하는 input-dependent transition으로 다시 나타납니다. 두 모델의 parameterization과 계산 알고리즘이 같다는 의미는 아니지만, 이 구조를 통해 KDA가 scalar decay보다 세밀한 memory retention을 제공하면서도 Gated DeltaNet과 유사한 recurrent computation을 유지하는 이유를 이해할 수 있습니다.
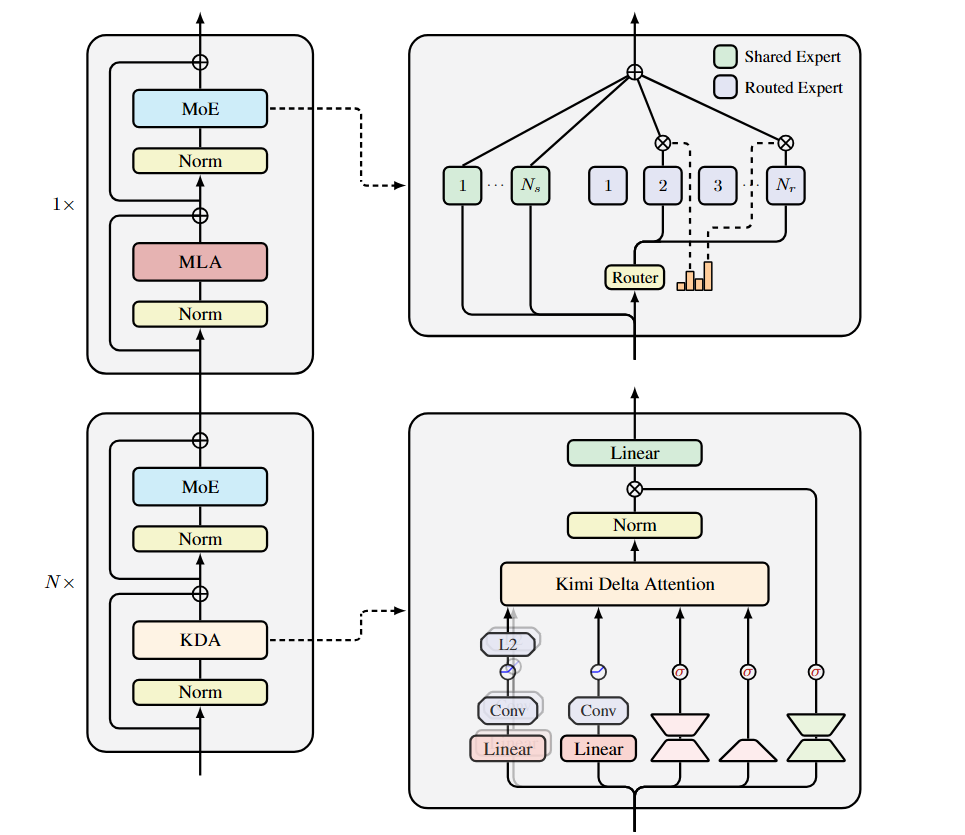
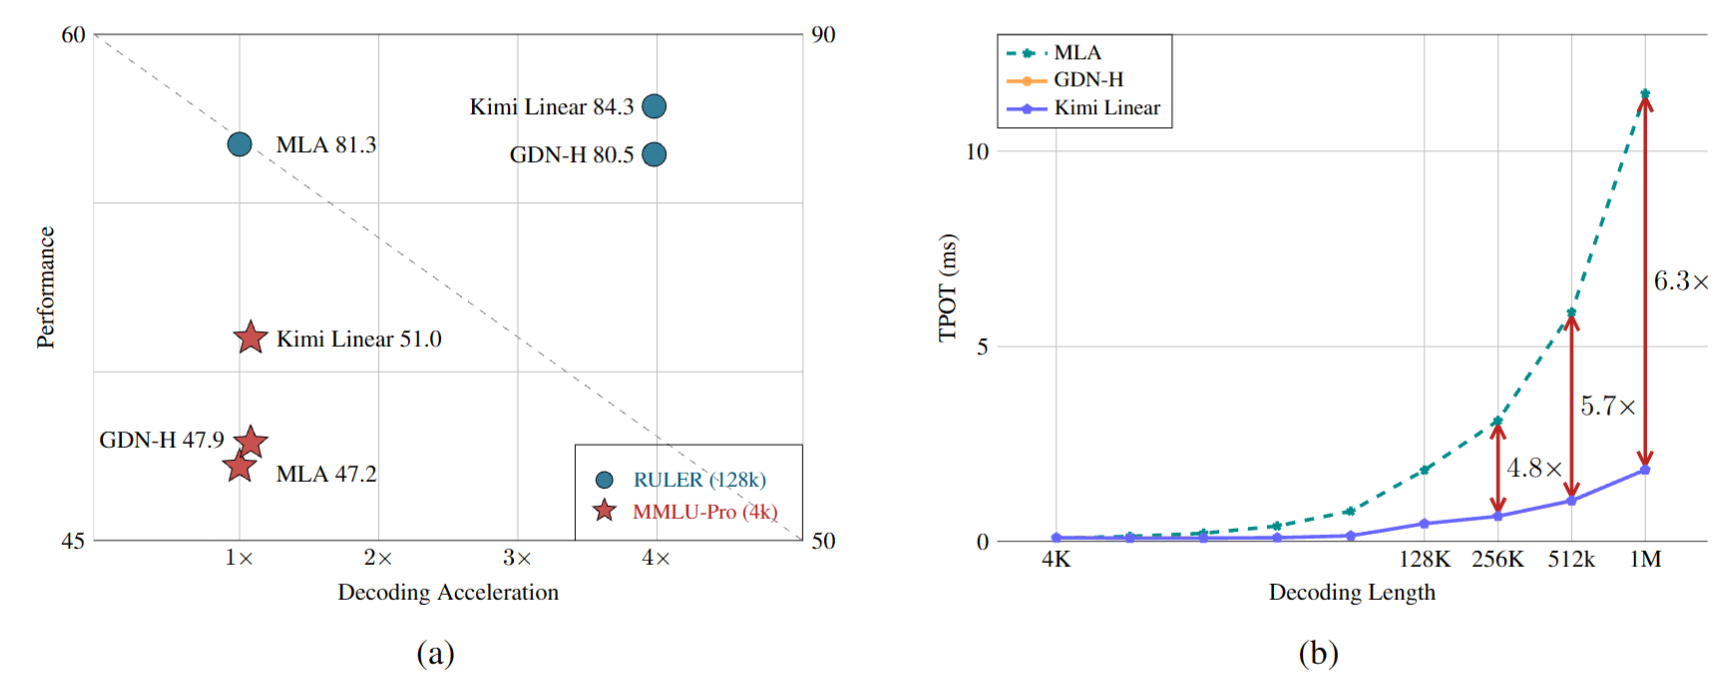
Kimi Linear는 KDA와 Multi-Head Latent Attention(MLA)을 결합한 hybrid architecture입니다. 논문의 비교 설정에서는 MLA-only model보다 높은 성능을 보였으며, 1M context에서 KV cache를 최대 75% 줄이고 decoding throughput을 최대 6배 높였습니다.
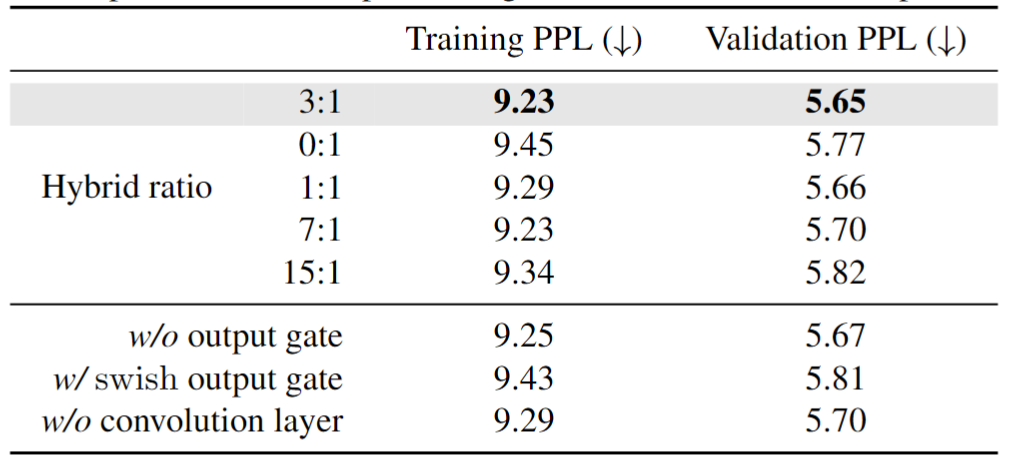
논문에서는 KDA와 MLA의 mixture도 ablation을 통해 비교했으며, 최종적으로 제시한 설정에는 KDA:MLA = 3:1을 사용합니다.
Online Learning 모델 근황
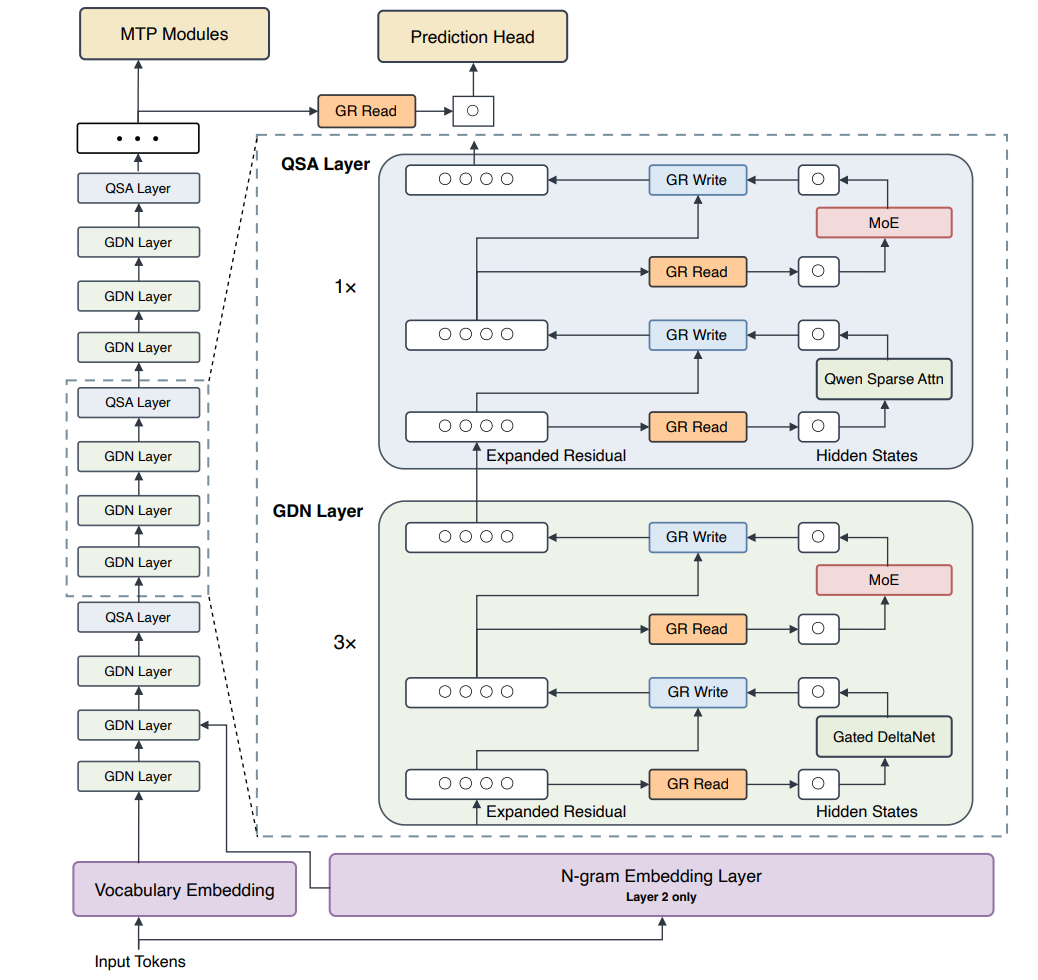
최근에는 online-learning 계열 sequence mixer를 attention으로 보완하는 hybrid architecture가 늘고 있습니다. 공개된 대표 사례를 보면 Kimi Linear는 KDA와 MLA를, Qwen3.8-Flash-Next는 Gated DeltaNet(GDN)과 Qwen Sparse Attention(QSA)를, Solar Open 2는 KDA와 softmax GQA를 결합합니다.
Hybrid architecture의 recurrent block은 sequence length와 무관한 크기의 state를 사용하므로 긴 context에서 decoding 효율을 높일 수 있습니다. 그러나 중간의 attention block은 여전히 KV cache를 사용하기 때문에, hybrid model 전체의 memory가 sequence length와 무관한 것은 아닙니다. 한마디로 attention을 완전히 없애기보다 꼭 필요한 곳에만 남겨 성능과 속도를 함께 확보하는 설계입니다.
최근 연구에서는 Qwen3.8-27B 기반 hybrid model에서 GDN을 포함한 linear layer를 NVFP4 W4A4로 양자화하더라도, 32K context에서 recurrent-state error가 무한히 누적되지 않고 plateau에 도달하는 사례를 보고했습니다.
마지막
online approximation → structured state transition → online learning objective라는 흐름은 모델의 이름은 달라도 모두 제한된 state에 과거를 압축한다는 공통된 문제를 다룹니다. HiPPO와 초기 SSM 연구는 continuous-time function space에서 과거 signal을 어떤 basis와 measure로 근사할지 정의하고, 그 결과를 유한한 state update로 이산화하는 방법을 발전시켰습니다. 이 관점에서 핵심 질문은 어떤 memory representation을 선택할 것인가였습니다.
Longhorn과 delta rule 계열은 출발점을 discrete-time recurrence로 옮깁니다. 이미 이산화된 state update를 주어진 규칙으로 받아들이는 대신, 현재 observation과 이전 state 사이의 trade-off를 나타내는 online convex objective를 먼저 세운 뒤 그 해 또는 gradient step으로 update를 유도합니다. 제게는 이 변화가 memory representation의 문제에서, 새로 들어온 정보로 memory를 어떻게 수정할지 묻는 memory editing의 문제로 중심을 옮긴 것으로 보입니다.
다만 최근 연구의 흐름을 online learning만으로 모두 설명하기는 어렵습니다. Mamba-3는 continuous-time dynamics를 discrete recurrence로 옮기는 과정 자체를 다시 개선하고, exponential-trapezoidal discretization 같은 방법을 통해 state update의 정확도와 안정성을 다룹니다.